本文对象:三款公开的设计资产——Minimal Gallery(手工策展的极简网页设计参考库)、taste-skill(面向 AI Agent 的前端设计规则技能包)、Impeccable(跨 harness 的 AI 前端设计技能包)。
文中的 star 数、命令清单、harness 适配细节均来自 2026 年 10 月前后的公开页面与仓库文档(
docs/HARNESSES.md自述为 point-in-time 快照),会随项目演进而变化,引用时请以仓库实时状态为准。本文自己的判断会明确标注。
这张封面的重点在左右两块。左边四张页面骨架是完全相同的——它们代表"模型默认会给出的那个答案",也就是训练集众数;右边三层能力不是三份素材,而是三种不同性质的约束:一层收敛方向、一层定义边界、一层约束决策。底部那排方块里,真正新的是最后两个:评审和修正——它们构成了一条能回到生成的边。
这条回边是全文的主线。
一、为什么 AI 生成的页面越来越像了?
聊"AI 做设计"很容易写成一串工具安利。本文换一个思路:先把"设计能力"拆成可安装、可执行、可评估的三层,再看每层对应什么样的资产,最后回答一个工程问题——把它们接进 Agent Loop 之后,还差什么。
1.1 一个典型现象
AI 现在能一口气生成完整页面:结构合理、响应式正常、交互齐备。但"完整"和"有辨识度"是两件事。把十几个不同产品、都由模型裸生成的落地页摆在一起,你会看到同一套视觉词汇反复出现:
- 字体用 Inter / Arial / 系统默认栈;
- 背景是蓝紫渐变;
- 大圆角,卡片套卡片;
- 标题上方一个圆角方块图标(tile);
- 三列 Features + 底部 CTA 收尾;
- 动效用 bounce / elastic 缓动。
这份清单不是我总结的,它是 Impeccable 的反模式清单里的条目——颜色上避免灰底白字(对比度不足)、避免纯黑纯灰(永远加一点色调),布局上避免到处套卡片,动效上避免 2015 年味道的弹跳缓动。一个开源项目专门把"AI 味"逐条写下来,这件事本身说明:问题不是随机的,是系统性的。(第 8 节会跑一次真实的裸生成——那份产出几乎逐条撞上了这张清单。)
1.2 问题真的出在"代码能力"吗?
不是。HTML / CSS、Flex 与 Grid、响应式断点、动画、甚至一整套 Tailwind 设计系统,模型全都写得出。真正缺的是 Design Decision——设计判断:在几个都"能跑"的方案里选哪一个,以及为什么选它。
AI 会"做",
但不知道"为什么这么做"。
值得注意的是,这些反模式并非能力缺陷,而是训练集众数。模型默认落在出现频率最高的那套 SaaS 模板上,因为那正是"最安全"的输出。要让输出偏离众数,只有两条路:给它更具体的上下文(品牌、参考、约束),或者给它一个能够判错的反馈信号。这两条路,恰好对应后文的三层资产。
1.3 从 UI Generation 到 Design Decision
上半条是大多数 Agent 的现状:Prompt 进,代码出,Done。下半条是设计任务真正的形状——参考在前,方向在中,评审在后,而且评审之后必须能回到生成。
两条链路的差别不在中间那一步(生成),而在两端:入口处多了"从参考里提取方向",出口处多了"评审并修正"。传统链路在生成处结束,设计链路在生成处才开始。
二、设计能力到底包含什么?
如果把"有设计能力"当成一个笼统的整体,就永远只能靠"把 prompt 写得更长"来逼近它。可以把它拆成三层,每层回答一个不同的问题。
2.1 Reference:什么是好的?
Agent 应该参考什么?
对应 Minimal Gallery。
它由设计师 Piet Terheyden 创建并维护,按"干净、极简、现代感强"的标准手工搜集网页设计案例。它的价值不是让你抄,而是——给 Agent 建立一个审美坐标系。从工程角度说,这是把一个开放搜索空间(“所有可能的网页”)收缩成一个有界的邻域(“这一族视觉语言”)。
2.2 Taste:应该怎么做?
面对多个都"能跑"的方案,Agent 应该如何取舍?
对应 taste-skill。
它覆盖的正是设计判断的组成部分:Typography、Color、Layout、Spacing、Visual Hierarchy、Motion、Density、Composition、Anti-patterns。写成公式就是:
Design Taste
=
Principles
+
Preferences
+
Constraints
+
References
2.3 Quality:怎么判断做得够不够好?
生成结果出来以后,谁来判断它到底好不好?
对应 Impeccable。
它提供的是可执行的动作,而不只是评价:Critique、Audit、Polish、Distill、Typography Review、Layout Review、Accessibility / Hardening、Visual Anti-pattern Detection。落到流水线上,它把 Generate → Done 改写成:
Generate
  ↓
Review
  ↓
Detect
  ↓
Fix
  ↓
Review again
2.4 三层对照
| 能力层 | 核心问题 | 对应资产 | 在流水线中的位置 |
|---|---|---|---|
| Reference | 什么是好的? | Minimal Gallery | 生成之前,收敛方向 |
| Taste | 应该怎么做? | taste-skill | 生成之中,约束决策 |
| Quality | 做得好不好? | Impeccable | 生成之后,检测与修正 |
| Agent Loop | 怎么持续迭代? | 三者组合 | 贯穿全程的反馈环 |
这张表是全文的骨架:后面每一节都是在拆其中一层,最后一节讲它们怎么被一个 harness 串起来。
三、Minimal Gallery:给 Agent 一个"参考世界"
3.1 为什么纯 Prompt 不够?
最常见的失败 prompt 长这样:
帮我做一个高级、现代、有科技感的官网
问题不在模型不努力,而在于:
“高级"到底是什么?
“高级"是一个评价词,不是描述词。不同 Agent 对它的理解完全不同:有的读成"大留白 + 细字重”,有的读成"深色背景 + 霓虹光效”。评价词无法约束生成空间,只会被模型翻译成它训练集里最常见的那个形象——也就是你已经在二十个页面上见过的那一个。
3.2 Reference 的真正价值
Reference 并不是:
Copy Website A
而是:
Reference
  ↓
Extract Design Patterns
  ↓
Reduce Design Search Space
  ↓
Generate
可以把它理解为:Reference 是 Agent 的视觉上下文。 上下文的作用不是给答案,是缩小解空间。搜索空间从"所有网页设计"收缩到"一组同族视觉语言"之后,模型不需要每次重新发明排版节奏,它只需要在这族语言里做局部决策。
3.3 如何让 Agent 使用 Reference?
一段可以直接复用的指令:
Analyze these references:

- Typography
- Layout
- Spacing
- Color
- Visual hierarchy
- Interaction
- Motion

Do not copy the page.
Extract the underlying design principles.
注意 Do not copy 这一句是必需品而不是客套。没有它,模型倾向做像素级复刻;有了它,任务才从"抄一个页面"变成"抽一套规则"。最终链条是:
Reference
→ Pattern Extraction
→ Design Principles
→ New Design
这里有个容易忽略的细节:抽出来的"设计原则"必须是可复述的短句,比如"正文行高 1.7 以上、字号层级不超过四级、强调色只出现在一个位置"。抽成"要显得高级"等于没抽。
四、Branding:先告诉 Agent"我是谁"
4.1 为什么 Branding 比"漂亮"更重要?
一个页面可能很好看,但:
不一定属于这个品牌。
同一个"生成一个官网"的任务,落到三类产品上应该是三套完全不同的设计语言:
| 产品类型 | 设计语言 | 具体表现 |
|---|---|---|
| 金融产品 | 稳定、克制、专业 | 高信息密度、低对比装饰、密集表格、弱动效 |
| AI 创业产品 | 前沿、实验性 | 高对比、强动效、非常规栅格、深色为主 |
| 高端消费品牌 | 大留白、Editorial | 大字号、强视觉、极简配色、图片主导 |
三张页面都可以"好看",但它们的取舍方向是相反的——金融产品要压装饰,AI 产品要加张力,消费品牌要让位给图。没有 Branding 这一层,模型只能取三者的平均值,而平均值就是"AI 味"。
4.2 Branding 可以被结构化
关键在于:品牌不用写成散文,可以写成约束。
Brand Personality:
  - Minimal
  - Precise
  - Technical

Typography:
  - Neutral Sans
  - Strong hierarchy

Color:
  - Low saturation
  - Limited accent colors

Layout:
  - Large whitespace
  - Strong alignment

Motion:
  - Subtle
  - Purposeful

Avoid:
  - Generic gradients
  - Excessive cards
  - Heavy shadows
注意 Avoid 段的权重——负向约束比正向形容词有效得多。正向词(“现代"“优雅”)要靠模型解释,负向词(“不要通用渐变"“不要卡片套卡片”)是可判定的。这也解释了为什么 taste-skill 和 Impeccable 都把反模式清单放在那么显眼的位置。
4.3 Branding 是 Agent 的"设计边界”
Brand
  ↓
Define Design Space
  ↓
Taste
  ↓
Make Design Decisions
Impeccable 把这个想法做成了具体机制:/impeccable init 会检查项目、询问受众/用途/约束/调性/证据,然后写入一份 PRODUCT.md。这份文件存的是**“产品真相"而不是视觉指令**——受众是谁、跑在什么场景、什么绝对不能做。之后所有命令都会读它。
这个设计里有一个值得学的地方:它的质量决定了后续所有命令的效果上限。 初始化时随手填,后面再怎么 polish 也 polish 不出品牌感。换句话说,Branding 不是视觉素材,而是 Agent 的 Design Context——它定义的是设计空间,不是设计结果。
五、Taste Skill:把"审美"变成机器可执行规则
5.1 什么是 Taste Skill?
先看它的物理形态:taste-skill 不是框架,也不是 npm 包,它就是一组 SKILL.md 规则文件。丢进项目里,AI 编码工具在生成前端代码时读取这些规则,从而收敛自己的审美。项目自述是 “Anti-Slop Frontend Framework for AI Agents”,GitHub star 数从 2026 年中的三万余涨到七月的五万余(快照数据)。
传统 Prompt 与 Skill 的差别在这里最能看清:
传统 Prompt:
Make it look premium.

Skill:
Premium
=
Typography hierarchy
+
Spacing discipline
+
Controlled contrast
+
Intentional motion
+
Strong composition
左边是一个形容词,右边是一组可检查的量。“premium” 无法验证,但"字号层级清晰、间距有节奏、对比受控、动效有意图、构图成立"每一条都可以被逐项看过去。
5.2 Skill 解决的是"判断规则”
以 Typography 为例:
不要:
- 默认全页面同字号
- 过度使用粗体

应该:
- 建立明确的字号层级
- 控制标题与正文的视觉重量
- 保持统一的垂直节奏
以 Layout 为例:
不要:
- 所有内容都放进 Card

应该:
- 使用空间建立层级
- 让 Section 本身成为视觉单元
这些规则单看都很朴素,但它们的作用是把隐性的专业直觉显性化为可执行条目。人类设计师不写这些,因为他们已经内化;模型没有内化过程,所以必须写下来。
5.3 从 Prompt Engineering 到 Skill Engineering
Prompt
= Instructions

Skill
=
Knowledge
+
Principles
+
Constraints
+
Decision Rules
+
Workflow
核心变化:不是让 Prompt 变长,而是让专家经验结构化。
结构化带来的是工程属性,这一点常被忽略:
- 可版本化:规则文件进 Git,设计规范的变更可以被 review、被回滚;
- 可参数化:taste-skill v2 带一套"三旋钮"系统,可以在文件顶部用 1–10 的数值调节强度,同一套规则能适配不同项目;
- 可组合:官方还派生了
gpt-tasteskill(面向 GPT / Codex 的强化版,动效约束更严、布局方差更大、反模板策略更激进)与image-to-code-skill(上传参考图 → 分析视觉语言 → 生成风格匹配的代码,而非像素复制); - 可交付:
SKILL.md是跨工具的通用载具,不绑定某一个编辑器。
顺带说一句,image-to-code-skill 那条路径尤其实用——它把"参考图"变成了 SKILL.md 之外的第二类参考输入,和第三章讲的 Reference 是同一件事的另一种形态。
六、Impeccable:让 Agent 学会"自我否定”
6.1 为什么一次生成远远不够?
代码生成型 Agent 的心智模型是:
Prompt
 ↓
Code
 ↓
Success
但设计不是"一次生成"问题,而是"反复观察"问题:
Design
 ↓
Observe
 ↓
Judge
 ↓
Adjust
 ↓
Observe again
两者对"完成"的定义不同:代码生成里,能跑就算完成;设计任务里,能跑只是开始。
6.2 24 个命令与它的组织方式
Impeccable 把设计过程编成了 24 个命令,按设计阶段分五组:
| 阶段 | 命令 |
|---|---|
| 建立设计系统 | init、document、extract、shape |
| 细化质量 | polish、audit、critique、harden |
| 调整风格 | bolder、quieter、distill、colorize、typeset、layout |
| 添加细节 | animate、delight、overdrive、onboard |
| 浏览器实时 | live、generate |
用法是"命令 + 目标",也可以直接用自然语言描述意图:
/impeccable audit blog
/impeccable polish settings
/impeccable harden checkout
/impeccable redo this hero section
这里最有工程价值的设计是命令的语义粒度。bolder / quieter 这种命令把"太无聊了"“太嗨了"这类模糊判断压缩成了一个动词——它不要求使用者会描述设计,只要求他能表达感受。这是一次很聪明的接口设计:把专业门槛从"描述"挪到了"判断”。
6.3 核心架构决策:规则检测与 LLM 评审分开
Impeccable 有一条我认为最值得学的架构决策——把「规则检测」和「LLM 检测」拆开:
- 确定性规则:61 条,不需要 LLM、不需要 API Key,CLI 与浏览器扩展直接跑,毫秒级返回,可离线、可嵌进 CI;
- LLM 评审:只跑在真正需要主观判断的地方——视觉层级是否成立、信息是否清晰、有没有情感共鸣。
分工的原则很清楚:能用规则判定的,不要浪费模型。
这条原则的外推空间比它本身大得多。它其实在回答一个通用问题:一个 Skill 里,哪些部分应该是"可枚举的检查",哪些部分才需要"模型理解"?答案是有稳定失败模式的部分全部规则化——检查是否存在渐变、字号层级是否少于三级、间距是否落在 4px 网格、对比度是否达标。剩下那些"这个 hero 有没有说服力"的问题,才交给 LLM。
顺带一提它的安装形态,因为它和下一章直接相关:
npx impeccable install                # 自动检测本机 harness
npx impeccable link --source=.impeccable --providers=claude,cursor
它自己不写代码——Impeccable 是跨 harness 的指导框架,实际代码由你选用的 AI 生成。这也意味着它的一个已知上限:效果好坏取决于 PRODUCT.md 的质量,以及 harness 能不能把它的能力完整加载进去。
七、把三个能力组合成一个 Design Agent
前面三节分别拆了三层。这一节把它们拼起来——这也是全文的核心。
7.1 三层加一个环
流水线的形状是:
Minimal Gallery  →  参考层:收敛方向
        ↓
Branding         →  身份层:定义边界
        ↓
Taste Skill      →  判断层:约束决策
        ↓
Agent Coding     →  执行层:产出实现
        ↓
Render           →  观察:拿到真实视觉输出
        ↓
Impeccable       →  评审层:检测、批评、修正
        ↓
Production UI
        ↺ 回到生成
7.2 每一层分别解决什么问题?
| 能力 | 核心问题 | 输入 | 输出 |
|---|---|---|---|
| Minimal Gallery | 什么是好的? | 一个模糊需求 | 一族参考与可复述原则 |
| Branding | 什么属于我? | 产品事实(受众/场景/禁区) | 设计空间边界 |
| Taste Skill | 应该怎么做? | 边界 + 原则 | 可执行的判断规则 |
| Impeccable | 怎么判断做得好不好? | 渲染出来的结果 | 问题清单 + 修正动作 |
| Agent Loop | 怎么持续迭代? | 以上全部 | 收敛的产物 |
有两个结构性的点值得强调:
第一,三层缺一不可,而且顺序不能换。 没有 Reference,方向是空的;没有 Branding,方向是别人的;没有 Taste,规则是散的;没有 Impeccable,产出无法证伪。倒过来说也成立——任何一层单独使用,收益都远小于三层串联。
第二,最后一环是回边而不是终点。 流水线的价值在于它有一个能返回的边:评审发现了问题,问题变成下一次生成的约束。这也是下一节要讲的重点。
八、实战:让 Agent 从 0 到 1 生成一个官网
前面七节都在讲机制,这一节换成实测。
先把实验设置说清楚,避免误读:
- 用本机
codebuddyCLI 的 headless 模式(-p)执行四次调用,四次都是同一个模型claude-opus-4.6,每个条件各自是独立会话、互不继承上下文; - 四个条件的输出约束完全相同:在当前目录写一个自包含的
index.html,CSS 内联,不引用任何外部资源(无 CDN、无外链字体、无图片文件),禁止读取目录外文件;Bash/WebFetch/WebSearch/Task工具全部禁用; - V1、V2 是重新生成;V3 不是重新生成,而是在 V2 的产物上跑一轮 audit → critique → polish;
- 截图由 Chrome headless 在 1280×900 视口下渲染,未做任何后期修饰。
必须强调:这是一次 n=1 的单样本对照。 它能说明的是"上下文差异在单次生成上确实留下了可测量的痕迹",不能说明模型普遍如此——要支撑更强的结论,需要多轮采样、跨模型复现和不看条件标签的盲评。
四档各自留下的痕迹:
| 指标 | V0 裸 Agent | V1 + Reference | V2 + Branding / Taste | V3 + 评审修正 |
|---|---|---|---|---|
| 产物大小 / 行数 | 33.9 KB / 914 | 8.8 KB / 369 | 7.4 KB / 312 | 9.2 KB / 379 |
gradient() 出现 |
17 | 0 | 0 | 0 |
box-shadow |
12 | 0 | 0 | 0 |
border-radius 取值 |
8 种(含 100px、50%) | 2 种(6/8px) | 2 种(3/5px) | 2 种(4/6px) |
出现 card |
41 | 1 | 0 | 0 |
transition |
25 | 2 | 5 | 8 |
@media 断点 |
2 | 1 | 1 | 3 |
<section> 数 |
7 | 4 | 4 | 4 |
| 生成耗时 | 4.3 s | 3.5 s | 3.8 s | 143.8 s |
8.1 V0:裸 Agent
提示词只有一句:
Build an AI developer platform landing page.
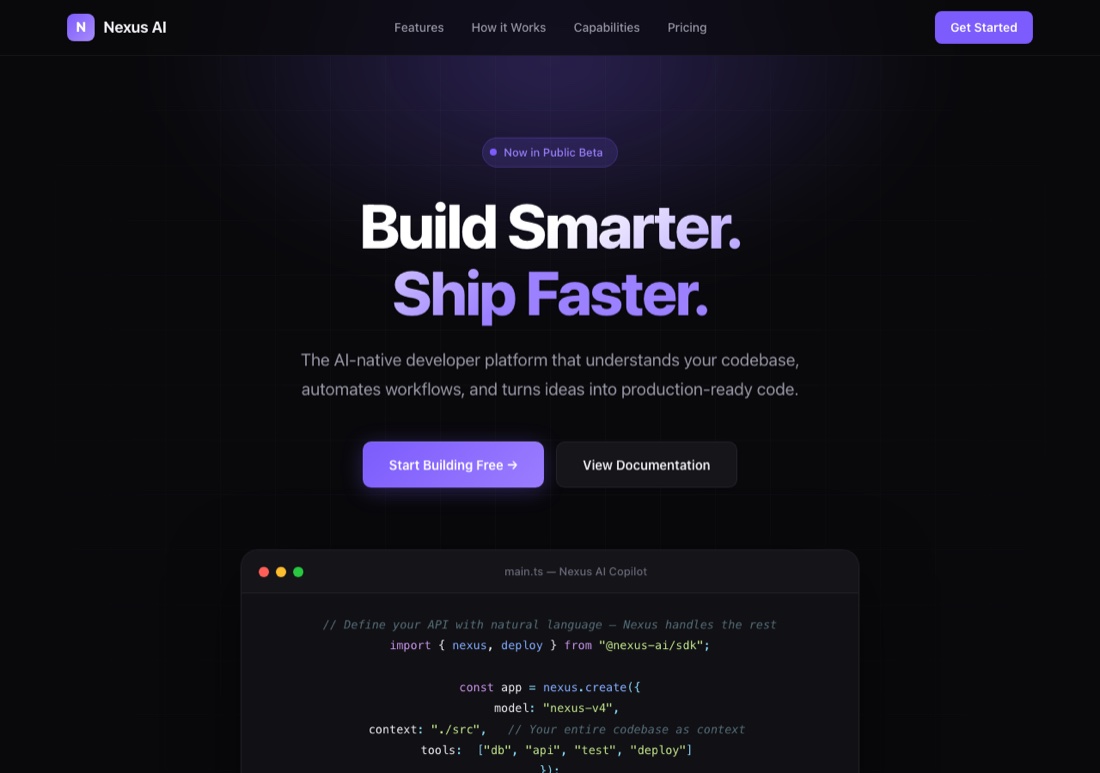
结果值得逐条对照第一节那份反模式清单:
- 背景
#09090b(近黑),强调色#7c5cfc(蓝紫),并且定义了--accent-glow: rgba(124, 92, 252, 0.15)这种"发光"变量,在样式里被用了 4 次; - H1 被包在
<span class="gradient">里,第二行 “Ship Faster.” 是渐变色文字; - 主按钮
background: linear-gradient(135deg, var(--accent), var(--accent-light)),副按钮是描边胶囊; - 导航下方一枚 “Now in Public Beta” 胶囊徽章;
- 代码演示区套了一个 macOS 三色圆点的窗口壳;
- 全页 41 处
card、12 处box-shadow、8 种不同的圆角取值。
第一节那张清单不是总结出来的,它就是一次真实裸生成的逐条复现。 这一档也确立了基线:模型的默认输出就是训练集众数。
8.2 V1:加入 Reference
V1 在同样的提示词前加了一段参考方向。这里要交代一个实验取舍:参考是以文字形式给出的——从极简设计站点的共性里抽出的七条:单栏居中、留白占比高、标题与正文字号差 3 倍以上、只用一套中性无衬线字体、几乎不用卡片边框与阴影、强调色只出现在一个位置、首屏只讲一件事。它并不是把原始页面截图直接喂给模型;这样做是为了让四个条件共享同一份文本输入、保持可比——换成图片会同时引入“视觉输入”这个新变量。
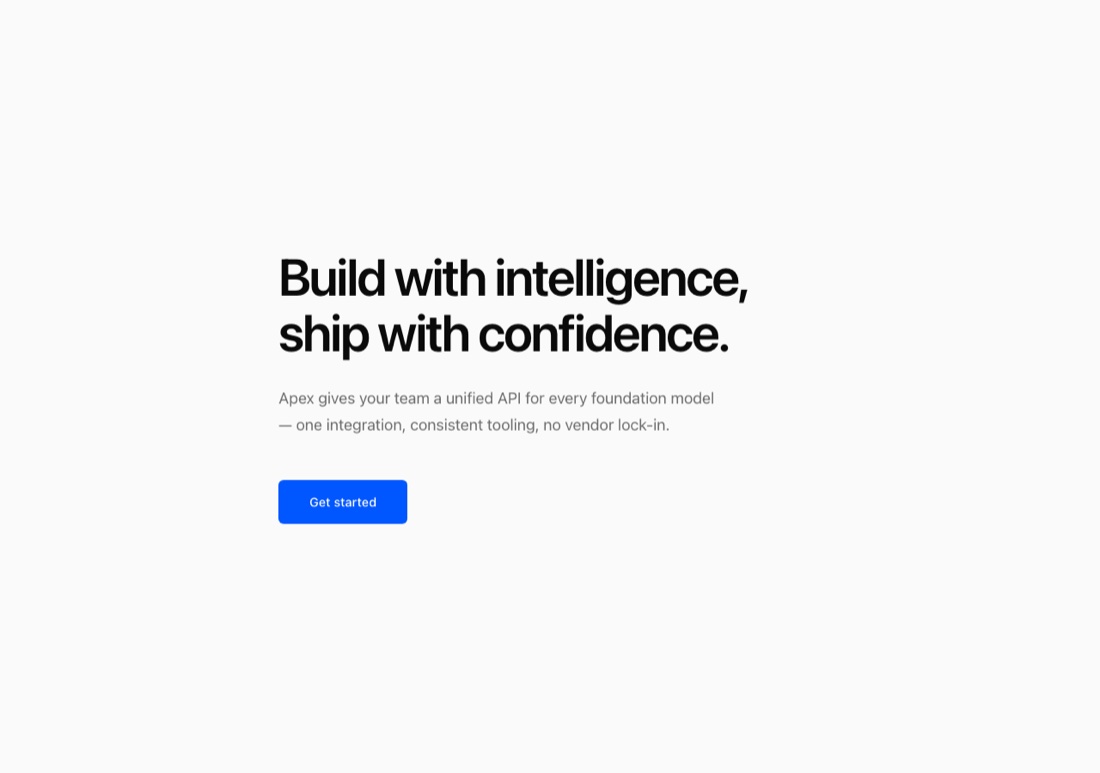
测量结果几乎是断崖式的:
gradient()从 17 降到 0;box-shadow从 12 降到 0;card从 41 降到 1;- 圆角从 8 种收敛到 2 种;
- 产物从 33.9 KB 压到 8.8 KB。
也就是说,“AI 味"里那些最刺眼的视觉特征,绝大部分是"没有方向"造成的,而不是模型不会做——给一段方向,它立刻就放弃了整套模板。
但这一档有明确代价:<section> 数从 7 个掉到 4 个,首屏只剩下一个标题、一句副标题、一个按钮。参考方向不区分"该删的装饰"和"该留的内容”,它把文字量也一起收掉了。(8.5 节的复现实验会把这个说法再收窄一次:文字量下降在三个模型上都成立,而结构是否塌缩因模型而异。) 而且它只能保证"不像所有其他页面",不能保证"属于这个品牌"。
8.3 V2:加入 Branding + Taste Skill
V2 在 V1 的基础上继续加入品牌定义(Minimal / Precise / Technical,以及排版、颜色、布局、动效四组规则)和一份反模式清单:禁止通用蓝紫渐变、灰底白字、纯黑纯灰、卡片套卡片、标题上方放圆角方块图标、把 Inter / Arial / system-ui 当主角、bounce / elastic 缓动、三列 Features + 底部 CTA。
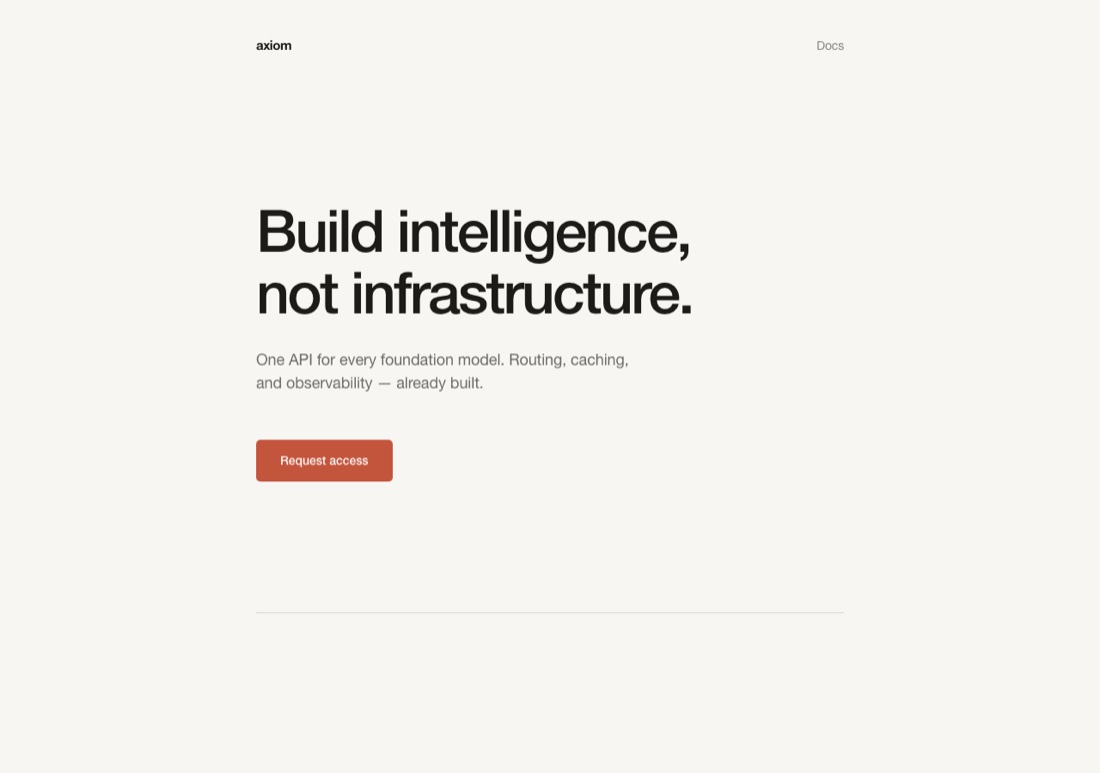
变化比上一档细微得多,但方向很清楚:
card归零,圆角进一步收到 3px / 5px,box-shadow保持 0;- 强调色收敛为一个陶土色
#c4553d,全页只有这一个强调色; - 底色从纯白系换成带暖调的
#f7f6f3,正文色#1c1b18也不是纯黑; <section>数没有变(仍是 4 个)——这一层的作用不是"删",而是"定"。
同样是 4 个 section,V1 的观感是"一个还没填内容的模板",V2 的观感是"一个已经决定了自己长什么样的页面"。这正是第四节那句"品牌是设计边界"在实测里的样子:它不改变组件数量,只改变取舍方向。
8.4 V3:加入 Impeccable 闭环
V3 不是重新生成,而是在 V2 的产物上跑一轮 audit → critique → polish:
audit     可访问性、对比度、字号层级、间距网格、响应式
critique  信息层级、清晰度、像不像模板
polish    把具体问题直接改掉
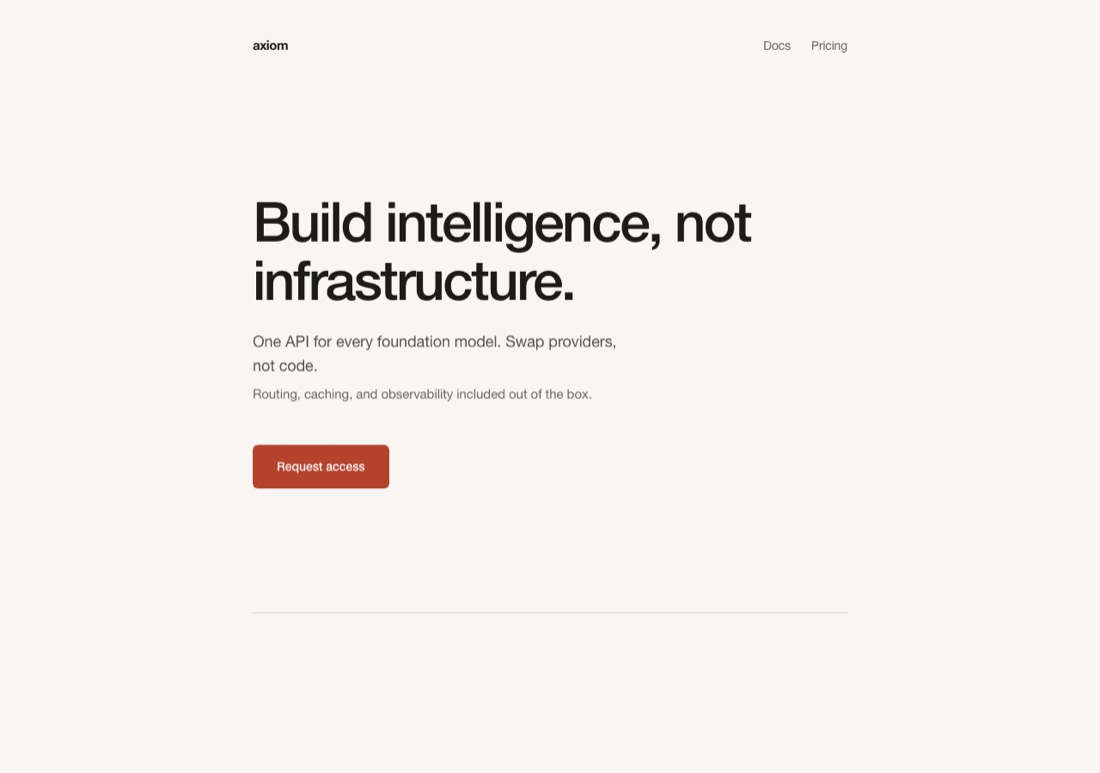
首屏截图几乎看不出区别——但这一档花了 143.8 秒,是前三档的 35 倍以上,共改动 14 处,其中没有一处是"审美"调整:
| 类别 | 实际改动 |
|---|---|
| 对比度 | 5 处灰字从 #85847e / #6b6a65 加深到 #64635e / #52514c,补到 4.5:1 |
| 强调色 | CTA 背景 #c4553d → #b5432c,文字改纯白;hover 从降透明度改为变深 |
| 网格 | 所有间距对齐 8px 倍数,清掉 52 / 100 / 152 / 160 等孤立值 |
| 响应式 | 新增 @media (max-width: 900px) 平板断点,断点从 1 个变 3 个 |
| 无障碍 | 为 .reveal 动画补 prefers-reduced-motion 查询 |
| 排版 | 去掉 H1 的 <br> 硬断行改自然换行;11 / 13.5 / 68px 这类非标准字号清理为 12 / 13 / 64px |
| 文案结构 | 把塞了功能列表的副标题拆为主句 + 辅助行;50 词长句拆成两段 |
对比 V0 的 4.3 秒:同样一份产出,前三档改变的是"它看起来像什么",第四档改变的是"它能不能被检查"。
8.5 复现实验:换两个模型,结论还成立吗?
单样本最大的问题是:它可能只是那一次生成的运气。所以我把同一套四档流程在三个模型上各跑了 3 次——3 模型 × 3 采样 × 4 档 = 36 次运行,每个采样内部 V0 / V1 / V2 的执行顺序随机打乱,V3 固定跑在该采样自己的 V2 产物上。
顺带交代一件事:8.1–8.4 走查的那个样本其实偏重——它的装饰痕迹是 70,而同一个模型在复现实验里的中位数只有 38。单样本确实会偏,这正是要跑复现实验的原因。
跨模型合并后(中位数 [最小–最大]):
| 指标 | V0 裸 Agent | V1 + Reference | V2 + Branding / Taste | V3 + 评审 |
|---|---|---|---|---|
| 装饰痕迹(渐变+阴影+card) | 19 [9–47] | 0 [0–1] | 0 [0–2] | 0 [0–2] |
border-radius 取值数 |
5 [1–16] | 1 [0–3] | 1 [0–1] | 1 [0–2] |
| 字体种类数 | 2 [1–3] | 2 [1–3] | 2 [1–4] | 2 [1–4] |
@media 断点 |
2 [1–3] | 1 [0–2] | 2 [0–3] | 3 [0–4] |
<h2> 数 |
3 [0–6] | 3 [0–4] | 3 [0–4] | 3 [2–4] |
| 可见文本量 | 2575 [715–4871] | 962 [454–1616] | 680 [489–1405] | 680 [516–1597] |
| 产物字节 | 28066 | 6864 | 6362 | 9501 |
复现了:装饰痕迹在 V1 归零。 三个模型的裸生成装饰痕迹中位数分别是 claude-opus-4.6 的 38 [36–47]、gemini-3.1-pro 的 19 [12–24]、gpt-5.6-sol 的 11 [9–11];加入参考方向之后,27 次运行(3 模型 × 3 采样 × V1/V2/V3)里装饰痕迹几乎全部落到 0,最差一次是 2。
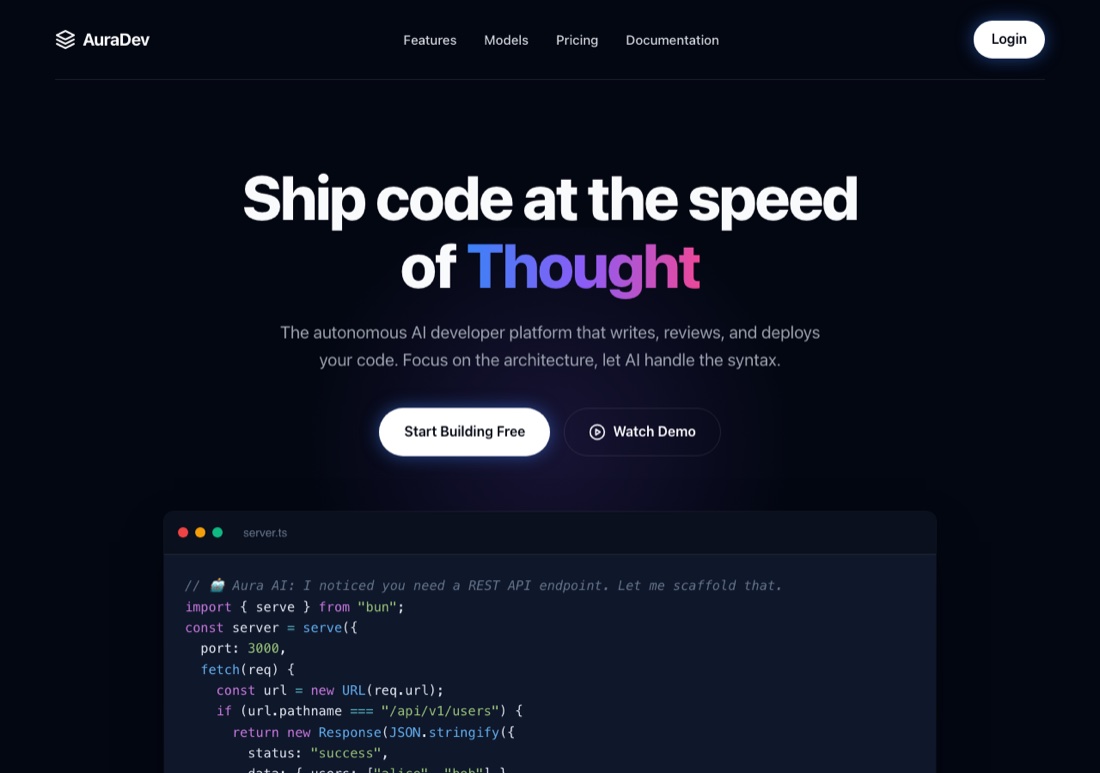
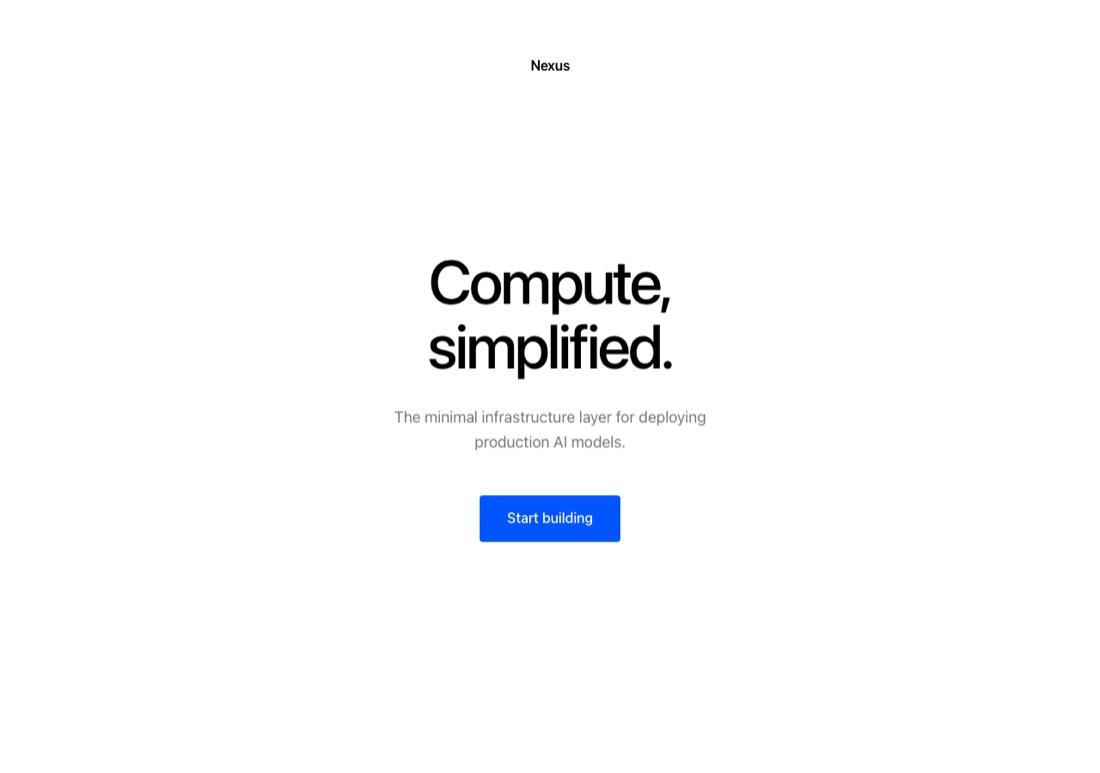
gemini 的这两张是同一套模板的另一个实例:V0 是深色底、“Thought” 一词的蓝到品红渐变、发光胶囊按钮、macOS 窗口代码块;V1 之后这些特征全部退场。结构没变,装饰全部消失——说明参考方向的作用点在装饰层,不在内容层。
复现了:可见文本量一致下降;但“结构塌缩”没有复现。 三个模型的可见文本量都降了 55%–73%(3999→1079、1165→526、2575→1116)。但 <h2> 条目数只在 claude 上塌(5→1),gemini 反而从 1 增到 3,gpt 保持 3。所以 8.2 节那句“信息密度一起被收掉”要收窄:被收掉的是文字量,不一定是结构。
复现了:字体不是变量。 四个档位的字体种类数中位数始终是 2——从 V0 到 V3,没有一次是靠“换字体”改掉 AI 味的。
没有复现的,是“默认模板只有一套”这个隐含假设。
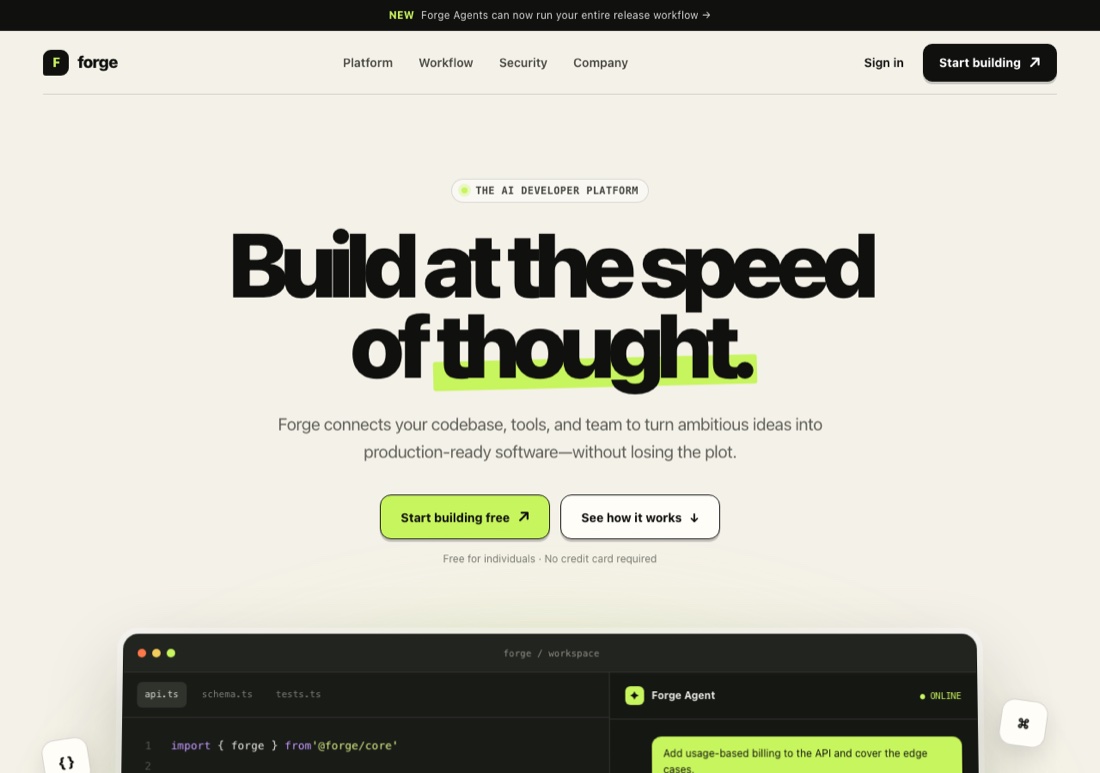
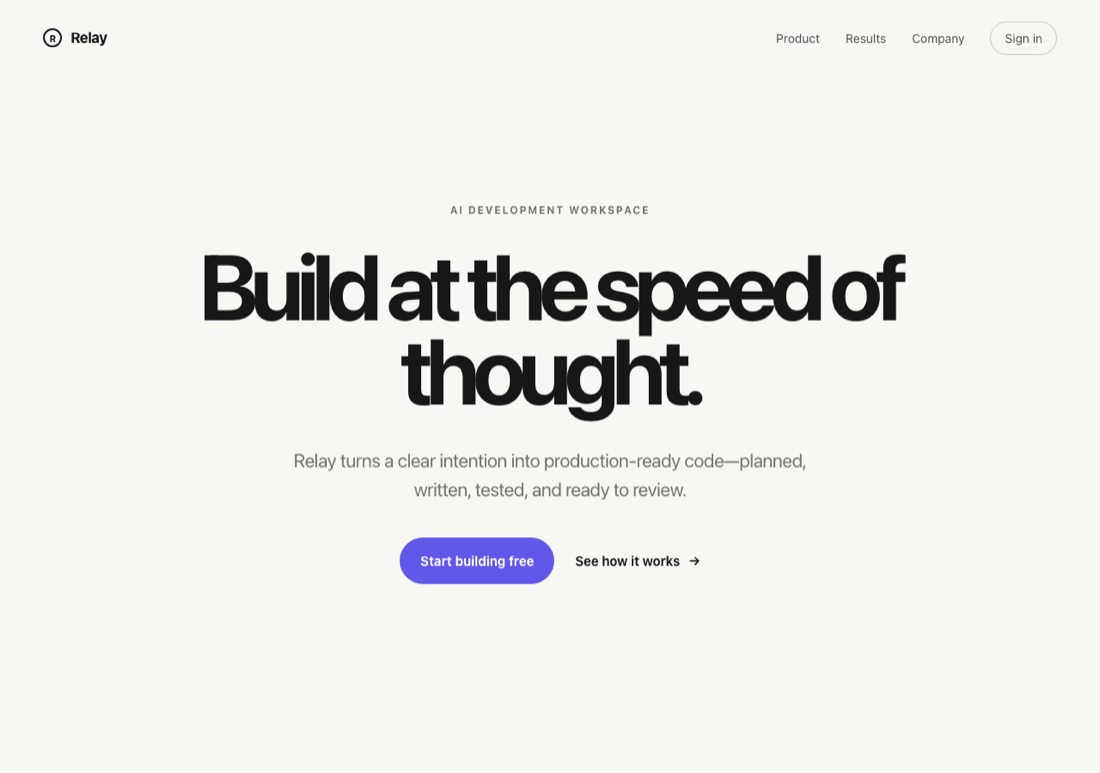
gpt-5.6-sol 的裸生成一上手就不是蓝紫 SaaS 那一族:暖白底、荧光绿高亮、超大标题、真实产品界面,属于 Linear / Vercel 式的克制模板,装饰痕迹只有 11,是三个模型里最低的。相应的是——参考方向对它的改动也最小:V0 与 V1 的首屏结构几乎一样(eyebrow + 大标题 + 副标题 + 两个 CTA),差别只在装饰细节。
所以“模型的默认输出是训练集众数”这句话要补一句:众数不止一个,落在哪一族取决于模型。 这直接影响预期收益——默认离目标越远,给参考的收益越大。
评审档的成本差异,比效果差异更大。 同一份评审提示词、同一份产物,三个模型的耗时是:gemini 63 秒、claude 128 秒、gpt 517 秒——相差 8 倍;而且 gpt 在 25 轮工具调用预算下三次都没跑完(Max turns (25) exceeded),把预算提到 60 轮才完成。
这是本节最“工程”的一条观察:Skill 的可移植性不只是文件格式,还包括执行预算。 一份 Skill 在一个 harness 上三轮干完的活,在另一个 harness 上可能要十倍时间和十倍工具轮次。第 9.3 节的 harness 差异,在这里有了具体的价格标签。
最后是效果方向:V3 从不回加装饰,只做补齐。 9 次评审运行里装饰痕迹始终是 0,而产物字节 9 次里 8 次增加,@media 断点中位数从 2 升到 3,<h2> 的下界从 0 提到 2。这与 8.4 节单样本的结论一致:评审档改的是可检查性(对比度、网格、断点、结构),不是观感。
最后照旧声明边界:36 次运行足以支撑“加参考会稳定消掉装饰层”这个结论,但仍不足以支撑更细的排序(例如“V2 比 V1 好多少”)——那需要盲评和更多采样。
8.6 四档连起来看
三个结论值得记下来:
第一,视觉上最大的跳跃发生在 V0→V1,而不是最后一档。 只要给方向,模型立刻离开默认模板;后面两档做的是收敛与加固——36 次运行的复现里,这一点每次都成立。这和直觉相反——人们通常以为关键在"模型更强"或"prompt 更长",而实测里最关键的一步是让 Agent 知道往哪个方向走。
第二,最贵的一档在首屏截图上几乎看不出来。 V3 的价值不在这一版的观感,而在"这一版是被检查过的":对比度有数值、间距有网格、断点有覆盖、动效有降级路径。这些不会让第一眼变好,但会让它以可复现的方式稳定下来。
第三,这一档也暴露了 Skill 的真实边界。 V3 能自动做完 audit 和 polish,是因为这些动作有明确判据(对比度阈值、8px 网格、断点覆盖);而"这个 hero 到底有没有说服力",它只能在 critique 里给出文字判断,无法自己验证闭环。能被规则化的部分可以自动化,不能被规则化的部分仍然需要人。
最后再声明一次边界:以上是单样本对照,样本量 1、模型 1 个、每个条件只跑一次。它足以支撑"上下文会显著改变默认输出"这个弱结论,不足以支撑任何强结论。
九、真正重要的变化:Skill 正在进入 Agent Loop
这一节把话题从"设计工具"抬到 Agent 工程。因为真正的新东西不是审美可以被描述,而是审美可以被装载、被执行、被评估。
9.1 Skill 不再只是 Prompt
传统理解:
Skill = Prompt

新的理解:
Skill
=
Context
+
Rules
+
Actions
+
Evaluation
区别在最后一项。Prompt 是单向的:我告诉你,你执行。Skill 是闭环的:里面既有"什么算对",也有"怎么检查对不对",还有"不对的时候怎么改"。Impeccable 之所以能跨 harness 工作,正是因为它把这四件事都写成了文件。
9.2 Skill / Agent / Harness / Feedback Loop
Skill
  ↓
Agent
  ↓
Harness
  ↓
Feedback Loop
四者的职责边界:
- Skill 负责"我知道怎么做"——专家经验的载体,声明式、可版本化;
- Agent 负责"我来执行"——把 Skill 的声明翻译成具体的工具调用;
- Harness 负责"我来组织整个过程"——它决定 Skill 能不能被加载、hooks 能不能挂上、子代理能不能 spawn;
- Feedback Loop 负责"我来判断做得够不够好"——规则检测 + 主观评审,输出下一次迭代的输入。
注意第三项。Harness 是这条链上最容易被忽略的一环,因为它在多数讨论里只是一个"运行环境"。但对 Skill 来说,harness 直接决定能力的上限。
9.3 Harness 差异:同一份 Skill 并不等价
Impeccable 在仓库里维护了一份 docs/HARNESSES.md,逐项标注了各 harness 的能力差异,并明说这是 point-in-time 快照、任何"仅 X 支持 Y"的结论都需实时复核。摘几条最关键的:
| 维度 | 差异 |
|---|---|
| Skill 安装路径 | Claude Code 读 .claude/skills/;Codex CLI 主路径是 .agents/skills/;Cursor 读 .cursor/skills/ 并回退到 .agents/skills/、.claude/skills/ |
| 事实通用路径 | .agents/skills/ 被 Cursor、Gemini、Copilot、OpenCode、Pi、Mistral Vibe、Antigravity 等共同读取,但 Claude Code 与 Codex 各走原生路径 |
| 编辑 hook | 只有 4 个 harness 有:Claude Code(PostToolUse)、Codex(PostToolUse)、Cursor(preToolUse,在坏写入落盘前拦截)、Grok Build |
| 子代理 | Claude Code 可在 skill 流程内程序化触发;Grok Build 有内置 spawn_subagent;Codex 需用户已允许,否则 skill 必须先问一次再停止;Cursor 无法被 skill 可靠触发 |
| Frontmatter 字段 | name / description 全支持;model / effort 仅 Claude 与 Grok;context / agent 仅 Claude;hooks 仅 Claude / Codex / Grok |
| 占位符替换 | 运行时 $ARGUMENTS、${CLAUDE_SKILL_DIR} 等仅 Claude Code 支持,其余 harness 靠构建期替换 |
| 未知字段 | 所有 harness 静默忽略——这反而让"全量发射字段"成为安全策略 |
从这张表能读出三条对写 Skill 的人有用的结论:
第一,可移植性不等于文件可移植,而是能力可降级。 同一份 SKILL.md 在 A 上能挂 hook 拦截坏写入,在 B 上只能生成完再扫一遍,在 C 上连扫描都没有。写得好的 skill 会把"没有 hook 时怎么办"也写进去——Codex 上"先问一次再停止"就是一种显式的降级路径,而不是静默失效。
第二,编辑时机决定了拦截能力。 Cursor 的 preToolUse 是在落盘前拦截,其余多是落盘后再扫。同样是"检测到问题",一个能阻止、一个只能修复。skill 的修复策略必须按 hook 时机分别设计。
第三,构建期转换是多 harness 的现实解法。 Impeccable 的做法是:以 Agent Skills 规范为共同基线,再用构建期转换生成各 provider 的产物。这跟"为每个 harness 维护一份 fork"是完全不同的维护成本量级。
换个角度看,这份文档其实是一份生态成熟度报告:Skill 是规范层的统一,Harness 是能力层的碎片化。写 Skill 的人一定会撞上这件事。
十、从 Design Skill 推演:哪些专家能力都可以 Skill 化?
如果"审美"可以被做成一组可加载、可执行、可检查的规则,那么其他专家经验呢?
Design Taste
Writing Style
Architecture Pattern
Security Review
Code Review
Product Sense
Domain Knowledge
Research Method
从本文的几个案例里,可以抽出几条判断标准——一个能力适合被 Skill 化,大致需要满足:
- 有可复述的规则:专家能把它写成清单,而不是"你多看看就懂了";
- 有可观察的产物:产物是文本、代码、页面这类可以被检查的东西,而不是"感觉";
- 有稳定的失败模式:反模式可枚举。Impeccable 的反模式清单、taste-skill 的"不许"段落,都是这一条的直接应用;
- 有可执行的修正动作:不只是"不好",而是有
bolder、quieter、distill这样的动词能落到下一步。
四条里缺任何一条,Skill 都会退化成"一段更长的 Prompt"——规则无法检查,产物无法观察,失败无法复现,修正无从下手。
按这个标准回看,安全评审(有明确规则、有扫描产物、有已知漏洞模式)和代码评审(有 lint 层 + 主观层,天然适合"确定性规则 + LLM 判断"的分工)恰好是最适合的两类;而"产品品味"这类更靠情境判断的能力,眼下更像 Branding 那一层——它更像边界声明,而不是判断规则。
Skill 的本质,是把隐性的专家经验转化为 Agent 可以加载、执行和评估的能力。
十一、未来:从 Coding Agent 到 Expert Agent
把 Agent 的演进排成一条线:
Code Generation      ← 会写代码
      ↓
Task Execution       ← 会完成任务
      ↓
Skill-driven Agent   ← 会按专家规则做
      ↓
Feedback-driven Agent← 会自己判断做得好不好
      ↓
Expert Agent         ← 会在一个领域持续做得对
关键在于每一级新增的能力是什么:第一级加的是生成,第二级加的是工具,第三级加的是规则,第四级加的是评估,第五级加的是领域内的长期一致性。
所以最关键的变化并不是:
Model 变得更大。
而是:
Agent 开始拥有越来越丰富的 Skill、工具和反馈闭环。
这也是为什么"设计品味"这件事值得单独写一篇:它是最难被规则化的能力之一,而它已经被拆成了可安装的资产——那么这个拆解方法本身,就是可以复用到别处的。
十二、结语:AI Coding 的下一阶段,是"品味工程"
回到文章主题:
Reference
   ↓
Brand
   ↓
Taste
   ↓
Generate
   ↓
Critique
   ↓
Polish
   ↓
Verify
AI Coding 的三个阶段,其实是三个不同的追问:
- 第一阶段问:能不能做出来?
- 第二阶段问:做得对不对?
- 下一阶段问:做得有没有品味?
所以一个真正成熟的 Design Agent,不应该只是:
Text → Code
而应该是:
Reference
   ↓
Understand
   ↓
Decide
   ↓
Generate
   ↓
Observe
   ↓
Evaluate
   ↓
Refine
   ↓
Verify
这两条链路的差别,不在于哪一步更快,而在于后半条可以被检查。能被检查的东西,才能被迭代;能被迭代的东西,才能被信任。
当"审美"也开始进入 Skill、进入 Agent Loop,AI Coding 才真正从代码生成走向产品创造。
参考与延伸
- Minimal Gallery — 手工策展的极简网页设计参考库
- taste-skill — 面向 AI Agent 的前端设计规则技能包(含
gpt-tasteskill、image-to-code-skill派生技能) - Impeccable — 跨 harness 的 AI 前端设计技能包;harness 能力对照见仓库
docs/HARNESSES.md - 本仓库相关文章:在动手之前先把想法跑起来:Claude Design 作者的 10 条工作方法
第 8 节的实验可复现:四个条件的提示词、四份 index.html 产物与统计脚本归档在仓库 .codebuddy/experiments/design-taste-v0-v3/,统计口径见其中的 analyze.py;8.5 节的复现实验归档在 .codebuddy/experiments/design-taste-replication/,其中 driver.sh 是完整运行参数,runs.csv 是 36 次运行的逐条指标,summary.txt 是统计输出。
「真诚赞赏,手留余香」
 爱折腾的工程师
真诚赞赏,手留余香
使用微信扫描二维码完成支付